Scribe v3とは
Scribe v3とは、会議や通話の録音を文字に起こすElevenLabsの音声認識モデルです。発言を話者ごとに分けたり、単語が出た時刻を添えたりできます。2026年11月9日には、録音用のScribe v3と、会話中に文字を表示するScribe v3 Liveが、いずれもAPI(他のソフトから呼び出す窓口)で利用可能になりました。
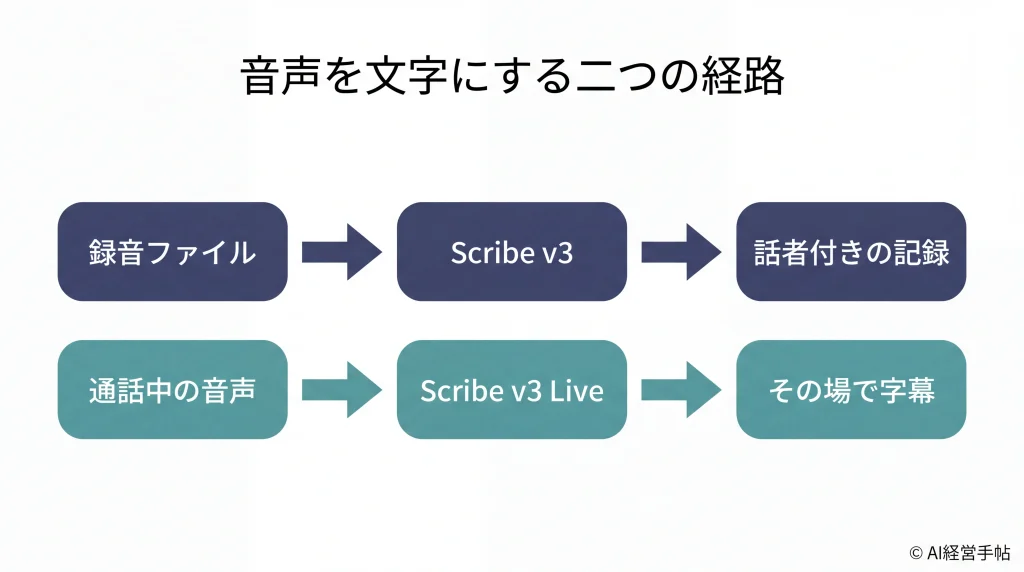
録音と生の音声は、どちらのモデルに渡す?
会議のあとに発言を確認するなら、録音ファイルをまとめて処理するScribe v3が候補です。話者分離という機能で、録音の中の「話者1」「話者2」といった区別を付けられます。誰の発言かを見ながら文字を追えるので、AI議事録で担当者や約束事項を拾うときに役立ちます。
対して、通話の字幕を見ながら応対するならScribe v3 Live。音声を順次送り、文字を受け取ります。話し手が考えながら間を置くと、無音を合図にする方式では「次の発言」として分かれることも。Liveでは、発話が終わったとモデルが判断した時点で文章を確定するターン検出を選べます。モデルを入れ替えるだけでこの設定に切り替わるわけではありません。
Liveでも話者の区別を有効にできます。APIでは、確定した文章に続いて、話者の区別を付けた結果が別に届く仕組みです。この区別は、音声が届くにつれて変わることもあります。通話画面では字幕を先に見せ、記録に残すときは後から話者の区別を添える、という分担が可能です。
録音で聞き間違いを減らす工夫
部署名や品番が頻出する録音なら、出てくるはずの用語の表記を事前に渡し、認識の手がかりにできます。たとえば社内で「エーキュー」と呼ぶ商品なら、表記の「AQ」を用語として渡しておくと、その表記で出やすくなります。ただし、渡した語を使うかどうかは前後の文脈からモデルが判断するため、必ずそのとおりに出るとは限りません。録音版では、発音された数を数字で出すか単語で出すかを選び、主に話される言語と混ざる可能性のある言語も指定できます。
「話者1」などの表示は、録音内の発言を分けるための目印。標準の出力では、氏名や所属までは付きません。「誰が納期を引き受けたか」が重要な会議なら、発言を聞き返して、発言者の表示も確かめましょう。単語の時刻が付いていれば、録音を冒頭から聞き直さずに該当箇所へ戻れます。
自社の会議で試すときに何を見る?
導入前の試聴には、発言が重なる録音と、社内用語が多い録音を混ぜると実務との差が見えます。見る点は二つ。「何と言ったか」と「誰が言ったか」です。たとえば商品名をよく聞き間違えるなら用語を渡し、発言者の取り違えが残るならマイクの配置を見直す、と対策を分けましょう。試験素材に顧客の通話を選ぶ場合は、先に録音を送ってよい範囲を社内で決めておきます。
2026年11月時点のElevenAPIの基本単価は、録音版が音声1時間あたり約0.20米ドル、Liveが約0.22米ドル。いずれも税別で、無音の時間も課金の対象です。用語の指定や文字起こし後の編集には別料金の項目があります。月の録音時間に加え、どの機能を使うかも見積もりの材料です。データの置き場所が気になる場合、ElevenLabsは企業向けに、EU・インド・シンガポールの分離した環境や、処理が終わるとすぐ音声と文字を消す設定、専用環境への導入を用意しています。録音を自社の中だけで処理したいなら、自社が管理する環境で動かせるNVIDIA Nemotron 3.5 Transcribeのようなモデルも比較対象です。録音はどこに置くか、文字に起こした後は誰が見られるか。どちらも導入先を選ぶ条件に入れておきます。
Topic読み上げの試験だけでは、話者の取り違えは測れない
ElevenLabsが精度比較に使ったFLEURSは、各音声クリップを一人が読み上げる試験用データです。この録音で測れるのは、主に言葉の聞き取り。話者を取り違えないか調べるため、同社は別に、会議や通話などの録音を集めました。カタログで「聞き取り精度が高い」と分かっても、複数人の会議で誰が話したかまで正しく判定できるとは限りません。
Scribe v3に関するよくある質問
- 字幕ファイルは作れますか?
- 録音向けのScribe v3は、再生時刻を含む字幕ファイル形式のSRTで出力できます。動画へ載せる前に、字幕の切れ目や固有名詞の表記を確認してください。
- Scribe v2を使っていると、直ちに移行が必要ですか?
- 2026年11月17日の確認時点ではScribe v2とScribe v2 Realtimeも提供中です。録音版の移行は同じAPIでモデルIDを変更できます。Liveの発話確定など新しい動作は別途設定します。