Scribe v2 Medical(スクライブ・ブイツー・メディカル)とは
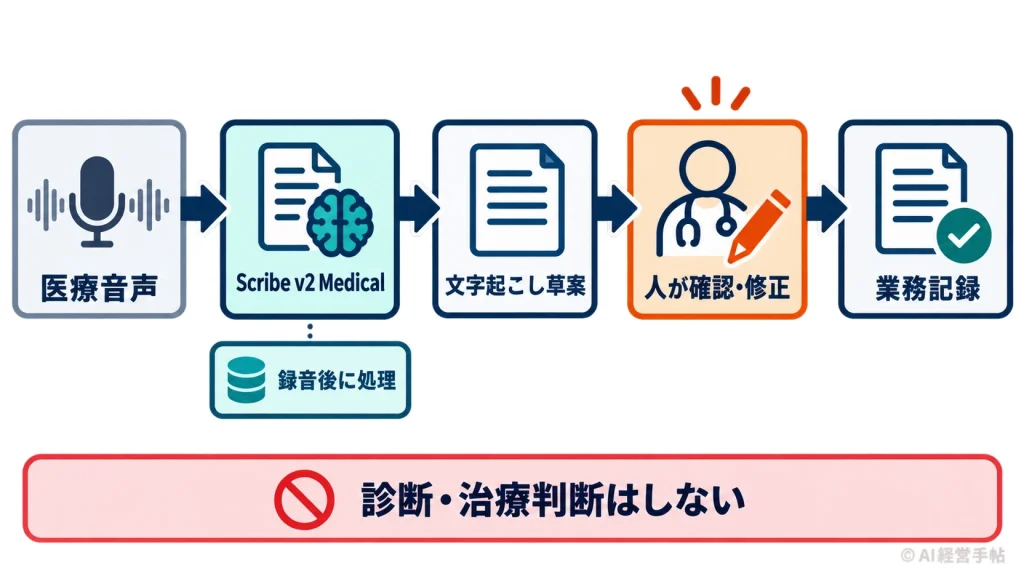
Scribe v2 Medicalとは、ElevenLabsが医療・臨床音声の文字起こし向けに調整した、バッチ処理型の音声認識モデルです。診察後の記録、臨床メモ、医療文書などの草案を作り、医療従事者の確認作業を助けます。診断や治療を決めるAIではなく、最終記録には人の確認と修正が必要です。
ElevenLabsの変更履歴では、2026年9月11日に一般提供が始まりました(評価結果をまとめた公式ブログは9月22日付)。通常のScribe v2と同じ音声文字起こし用APIから選べ、2026年9月時点で90以上の言語、話者の区別、音声内の出来事の表示、個人情報に関わる項目の検出などに対応します。公式の位置づけは、開発者や組織が自社のアプリへ組み込むためのAPIです。画面を開いてすぐ使える完成品ではなく、導入には組み込みの開発作業が要ります。料金は通常のScribe v2と同額で、医療向けだからという上乗せはありません。
一般的な文字起こしAIと何が違う?
一般的な音声認識は、日常会話や会議の言葉を幅広く文字にします。Scribe v2 Medicalはその土台を医療向けに調整し、薬剤名、解剖、病理、臨床で使う表現を認識しやすくしたモデルです。医師の口述、患者との会話、研究や管理業務の録音など、専門語が多い音声が想定対象です。
どれだけ良くなったのか。ElevenLabs自身が出している数字は1つではありません。公式ブログは臨床音声の誤り(WER)が基のScribe v2より約35%少ないとし、公式のモデル一覧は「臨床音声で誤りが18%少ない」、製品ページは医療用語だけを見た指標で「15%少ない」としています。同じ製品でも、何をどの音声で測るかで数字は15%〜35%と変わります。いずれも比較相手は基のScribe v2であって、他社製品との差ではありません。
医療語に寄せた分、日常会話が犠牲になっていないかも測られています。公式ブログによると、日常の話し言葉6,000件(Common Voiceから作った評価用データ)では基のScribe v2と同じ5.3%で、四捨五入して差がありませんでした。診察中の普通の受け答えごと文字にする狙いです。
ただし、「医療向け」という名称だけで自院の診療科や日本語の固有名詞に強いとは判断できません。薬の商品名、略称、施設名、話者の癖、マスク越しの声、周囲の雑音で結果は変わります。公開された平均値ではなく、実際の録音で何分の修正が必要かを比べることが導入判断の基準になるでしょう。
録音後の処理とリアルタイムを分ける
Scribe v2 Medicalは、保存された音声ファイルを送って結果を受け取るバッチ処理用です。診察や会話の最中に字幕を返すリアルタイム用途には、ElevenLabsはScribe v2 Realtimeを案内しています。
この違いは単なる待ち時間ではありません。録音後に処理するなら、音声の保存場所、送信のタイミング、文字起こし後の削除、担当者の確認待ちを業務手順へ組み込めます。リアルタイムなら、その場で誤認識したときの表示や訂正方法が別に必要です。用途を「あとで記録する」か「その場で支援する」かに分けてからモデルを選ぶと、機能の取り違えを防げます。
文字起こし草案を、診療判断にしない
公式文書が示す意図は、文書作成や管理業務に使う草案の生成です。出力を医療従事者か権限を持つ利用者が確認し、誤りを直すことが前提。モデル単独で音声を解釈し、診断、治療、臨床上の助言を行う用途は想定されていません。
特に、薬剤名、用量、左右、否定表現、日付は、1語の誤りでも意味が反転します。「異常あり」と「異常なし」を同じ重さの誤字として集計してはいけません。検証では、全文の誤り率に加えて、患者安全や請求に影響する語を別に数えます。
運用時は、元音声、AIの草案、人が修正した確定版を区別します。誰がいつ確認したかも残せば、誤りが見つかった際にどの段階で入ったのかを追いやすくなるでしょう。
患者情報を送る前に何を確認する?
ElevenLabsは、米国の医療情報保護に関するHIPAAについて、Enterprise契約であること、事業者間契約のBAAを結んでいること、データを保持しない設定のZero Retention Modeを有効にしていること、この3つがそろって初めて適格になると説明しています。Zero Retention Modeとは、送った音声と受け取った文字起こしを、1回の処理が終わるたびに削除する設定です。保護対象の医療情報を扱う前に、まず営業窓口へ連絡するよう求めています。
モデル名や機能だけで「HIPAA準拠」と判断はできません。契約と設定に加え、利用側のアプリが文字起こし結果を保存する期間、アクセスできる人、監査ログ、処理地域を確認します。Zero Retention Modeで提供側の保持を止めても、自社システムに保存した出力まで自動で消えるわけではありません。
日本で使う場合も、米国の制度名だけで安全性を結論づけず、自組織が適用を受ける法令、院内規程、患者への説明、委託先管理と照合してください。法務、情報セキュリティ、医療現場の担当者が同じデータフローを見ることが重要です。
小さく試す時の評価項目
最初は診療科と録音条件を絞り、同意や権限を確認した評価用音声で試します。比較するのは、専門語の誤り、薬剤名や数値など重大語の誤り、話者の分離、処理時間、人が確定版に直すまでの時間です。「精度が高い」ではなく、修正時間が何分減り、重大な見落としが何件残るかへ置き換えて評価します。
専門語を事前に伝えるキーターム機能もありますが、正しい認識を保証する辞書ではありません。候補を渡した後も原音との照合は残します。費用への跳ね返りにも注意が要るでしょう。公式のAPI仕様では、キーターム機能を使うと基本料金に20%が上乗せされ、さらに100件を超えて渡したリクエストは、音声がそれより短くても20秒分として課金されます。短い録音を大量に処理する使い方ほど、ここが効いてきます。個人情報にあたる項目を検出する機能も、公式ヘルプでは30%の上乗せです。採用判断には、モデル利用料だけでなく、録音保管、確認担当者、誤りの再点検、契約やセキュリティ審査の費用も含めた比較が必要です。
Topic薬の名前は、単独で言うほど間違えられる
ElevenLabsが公開した評価には、自社モデルの弱点も載っています。薬剤名が文の中に出てくる場合の誤り率は7.5%でしたが、前後の文脈なしに薬剤名だけを単独で言った場合は14.3%と、およそ2倍でした。はっきり1語だけ言うほうが正確に伝わりそうに思えますが、AIは前後の言葉から見当をつけているため、手がかりが無いほど弱くなります。公式ブログは、文脈が無いとひと音の聞き違いが記憶に残る失敗になるとして、etodolac(エトドラク/消炎鎮痛薬)が「It’ll do the luck」=薬とは無関係な英語の言い回しとして書き起こされた例などを挙げています。口述するなら単語を並べず、文として話したほうが安全だということです。
Scribe v2 Medicalに関するよくある質問
- 日本語の医療音声でも精度向上が確認されていますか?
- 日本語を含む90以上の言語に対応しますが、公式ブログが載せている医療音声の評価は、英語・フランス語・ドイツ語で測ったもの2件と、英語だけで測ったもの2件です。日本語での評価は含まれていません。自院の診療科、薬剤名、録音環境を使った検証が必要です。
- 医師と患者の発言を分けて文字起こしできますか?
- 話者分離に対応し、発言を話者ごとに分けられます。ただし、話者ラベルは本人確認ではありません。誰が話したかを確定記録へ入れる場合は、元音声と参加者情報を人が照合してください。
- 薬剤名や施設名を事前登録できますか?
- キーターム機能で、認識してほしい語句を事前に渡せます。2026年9月23日時点の公式API仕様では、1回につき1,000件まで、1件あたり50文字未満、しかも1件は5語までという制限があります。公式ヘルプには上限を100語句とする古い説明が残っているため、実装時は API 仕様のほうを見てください。
- Scribe v2 Medicalではない通常のScribe v2を医療音声に使ってはいけないのですか?
- 禁止されているわけではありません。ElevenLabsは医療・臨床音声にはScribe v2 Medicalを推奨しており、両者は同じAPI・同じ料金で、モデルIDを切り替えるだけです。乗り換えの障壁が小さいので、自院の録音で両方を走らせて比べるところから始められます。