自己教師あり学習とは
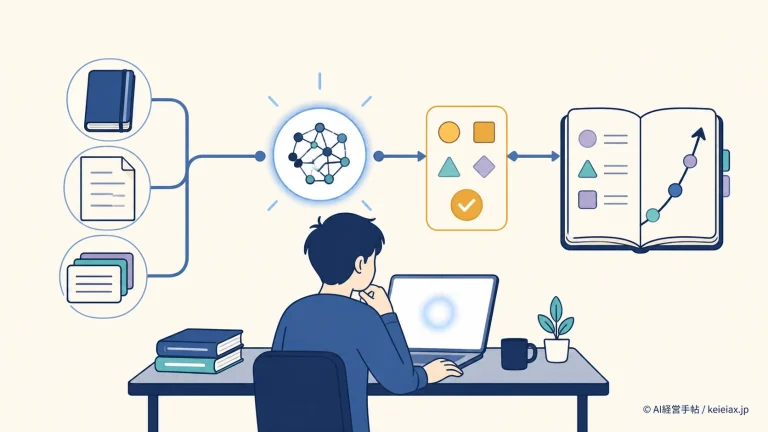
自己教師あり学習とは、人が正解(ラベル)を付けていないデータから、データの一部を隠して残りから当てさせる形で、問題と答えを自動で作って学習する方法です。BERTやGPTといった、文章を扱うAIモデルの事前学習に使われてきました。
穴埋め問題で、正解を自分で作る
やり方は、学校の穴埋め問題に似ています。文章の一部を隠し、残った部分から隠した言葉を当てさせる。答えは元の文章にそのまま書いてあるので、人が1問ずつ正解を用意しなくても、文章があるだけ問題を作れます。
2018年にGoogleの研究者が発表したBERTは、文章を細かく区切った単位のうち15%をランダムに隠し、前後から当てさせました。同じ年にOpenAIが発表したGPT-1は、文章の続きに来る言葉を当てる形をとっています。どちらも、ChatGPTの一般公開(2022年11月30日)より4年ほど前の研究です。
穴埋めを当て続けると、なぜ言葉がわかるようになるのでしょうか。Meta(当時はFacebook)の研究者は2021年の解説で、「サバンナで◯◯が◯◯を追いかける」という文を例に挙げました。この穴を埋めるには、追う側はライオンやチーターで、猫がネズミを追うのは台所であってサバンナではない、と知っていなければなりません。当てる練習を重ねるうちに、言葉の意味や文の組み立てが身についていくわけです。
教師あり学習・教師なし学習と何が違う?
教師あり学習は、人が1件ずつ正解を付けたデータで学びます。決まった仕事では高い成績を出せる反面、ラベル付けに手間と費用がかかるのが難点です。同じ解説は、「世界のすべてにラベルを付けることは、現実には不可能」と書き、教師あり学習だけで進める限界を指摘しました。
教師なし学習は、正解のないデータから、似たもの同士のまとまりや傾向を見つける方法です。自己教師あり学習も、人がラベルを付けない点は変わりません。違うのは、「隠した部分を当てる」というはっきりした問題と答えを、データから自動で作って学ぶところ。
ラベル付けは、もう要らなくなる?
事前学習の段階では要りません。ただし、なくなったわけでもないのです。自己教師あり学習が担うのは、幅広い基礎力をつける事前学習まで。特定の仕事に合わせる仕上げ(ファインチューニング)では、BERTもGPT-1も、人がラベルを付けたデータを使っていました。
重さはまるで違います。BERTの論文によると、事前学習には専用の計算機を何台も並べて4日かかり、仕上げは同じ種類の計算機1台で長くても1時間でした。土台づくりは大仕事で、仕上げは軽い。ラベル付けの出番が、土台づくりから仕上げへと小さくなったわけです。
その後、規模の大きいモデルでは、仕上げをしない使い方も出てきました。スタンフォード大学の研究者らは2021年の報告書で、GPT-3は教え込まれていない多くの仕事を、指示の文章(プロンプト)だけでそれなりにこなせると書いています。会社でAIを使うときに一から学習させなくて済むのは、開発元がこの土台づくりを済ませているからです。
画像や動画にも広がっている
Metaの研究者の解説は、画像や動画では文章より難しいとも述べていました。隠れた単語なら、辞書にある言葉すべてに「ありそうな度合い」の点を付けられます。ところが動画の続きは無限にあり、並べて点を付けることができません。
それでも応用は進みました。画像では、同じ写真を少し変えた2枚を「同じもの」と見分けさせる方法(対照学習など)が成果を上げています。Metaは2025年6月、100万時間を超える動画を、人が説明を付けないまま学ばせたV-JEPA 2を発表しました。
TopicBERTもGPT-1も、論文では「教師なし」と名乗っていた
自己教師あり学習の代表例に挙げられるBERTとGPT-1ですが、2018年の論文には「自己教師あり(self-supervised)」という言葉が一度も出てきません。BERTの論文は事前学習の2つの課題を「教師なしの課題」と書き、GPT-1の論文も「教師なしの事前学習」と呼んでいました。呼び名が切り替わった理由を、当時Facebook(現Meta)でAI研究の主任科学者を務めていたヤン・ルカン氏らは、2021年にこう説明しています。「教師なし」は手がかりを何も使わない学習のように聞こえ、誤解を招く。実際には、教師あり学習よりもずっと多くの手がかりを、データそのものから受け取っている、と。古い資料に「教師なし学習」と書かれていても、中身はここで説明した学び方を指していることがあります。
自己教師あり学習に関するよくある質問
- 研究者は、なぜ自己教師あり学習をそれほど重視するのですか?
- 人の学び方に近いと考えられているからです。Meta(当時はFacebook)の研究者は2021年の解説で、人や動物の知能の大部分は、観察を通じて身につけた世界についての常識だという仮説を紹介しました。人が20時間ほどの練習で車の運転を覚えられるのも、この下地があるからだといいます。自己教師あり学習は、その下地をAIに持たせる有望な方法の1つと位置づけられています。
- 自己教師あり学習は、最近になって生まれた方法ですか?
- いいえ。スタンフォード大学の研究者らは2021年の報告書で、この方法は何十年も前からあり、深層学習の初期にはむしろ主流だったと振り返っています。その後の約10年は、ラベル付きのデータが増えるにつれて教師あり学習に押されていました。言葉を扱うAIの土台として定着したのは、BERTを使うことが当たり前になった2019年ごろからです。